
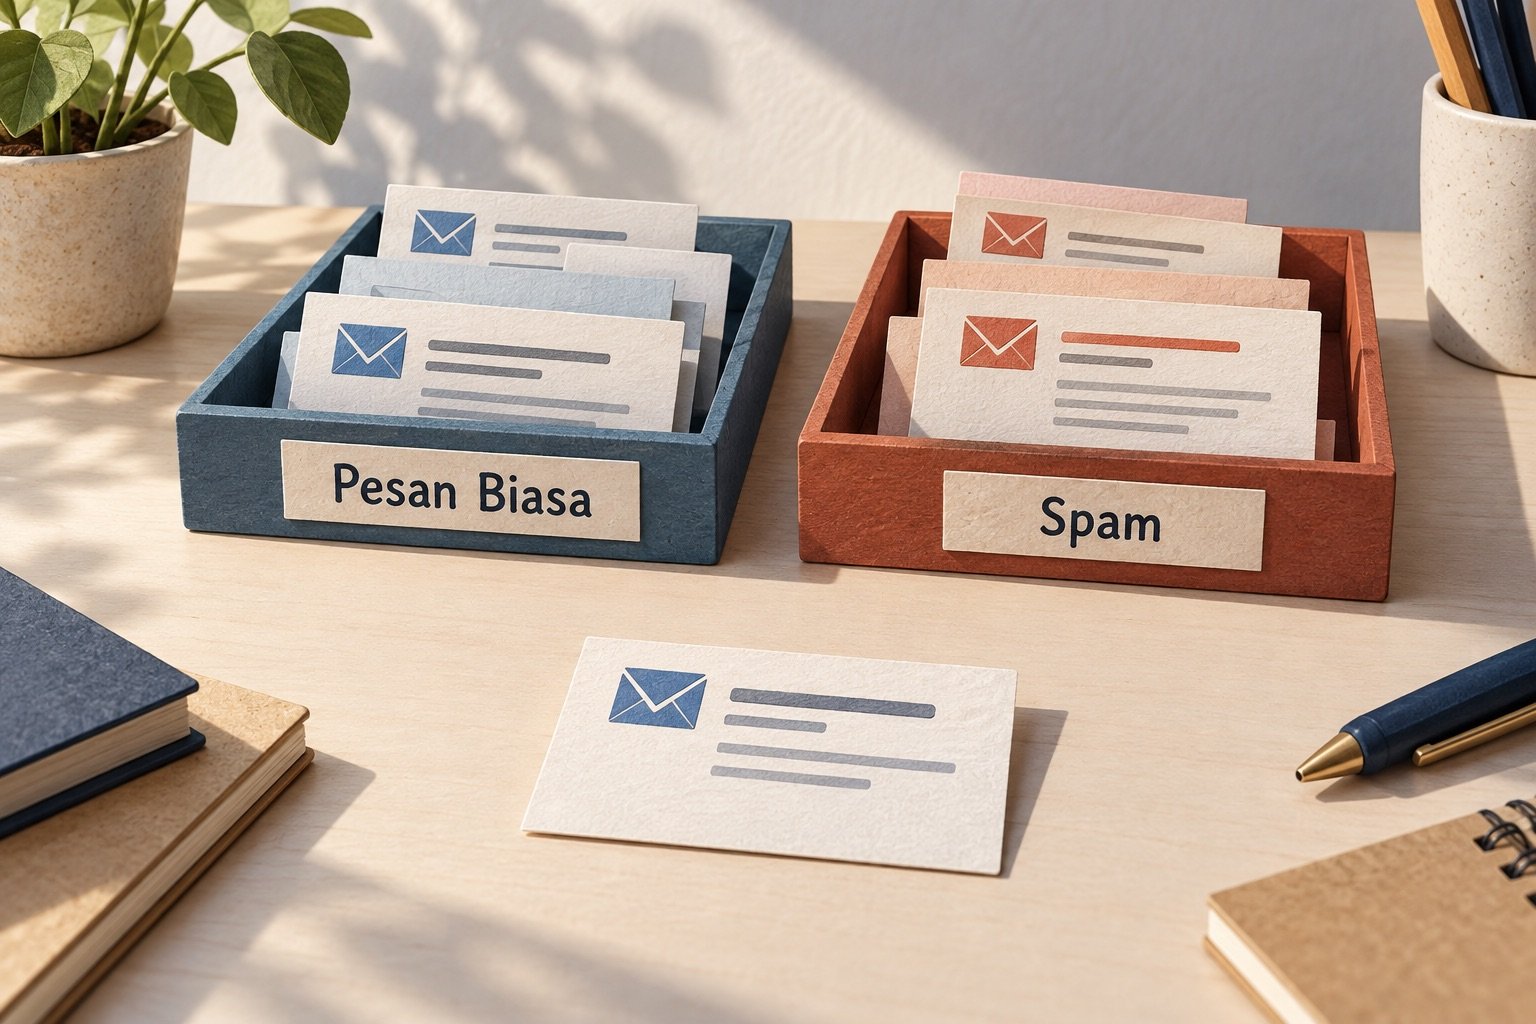
Machine learning adalah cabang kecerdasan buatan yang menggunakan data untuk melatih model agar dapat mengenali pola dan membuat prediksi atau pengelompokan pada data baru. Dalam bahasa Indonesia, istilah ini disebut pembelajaran mesin. Contohnya adalah sistem yang mempelajari contoh email berlabel spam dan pesan biasa, lalu memperkirakan kategori email yang baru masuk.
Komputer tetap memerlukan program, tujuan, dan pengawasan manusia. Perbedaannya terletak pada cara membentuk keputusan: sebagian pola dipelajari dari contoh data, alih-alih seluruh kriteria ditulis sebagai aturan satu per satu.
Apa Perbedaan Machine Learning, AI, Dan Deep Learning?
AI merupakan bidang yang lebih luas untuk membuat sistem menjalankan tugas yang memerlukan kemampuan seperti penalaran, pengenalan pola, atau pemahaman bahasa. Machine learning adalah salah satu pendekatan di dalamnya. AI juga dapat memakai aturan yang dirancang manusia tanpa proses pelatihan model.
Deep learning merupakan bagian dari machine learning yang menggunakan jaringan saraf dengan banyak lapisan. Jadi, ketiganya saling berkaitan, tetapi tidak berarti sama. Untuk konteks yang lebih luas, baca pengertian dan contoh penerapan AI.
Bagaimana Cara Kerja Machine Learning?
Secara sederhana, alurnya dimulai dari persoalan yang jelas dan data yang relevan:
- Tentukan tugasnya. Misalnya, mengelompokkan email menjadi spam atau pesan biasa. Tentukan pula kesalahan seperti apa yang paling merugikan pengguna.
- Siapkan data. Kumpulkan contoh yang diizinkan, periksa kualitasnya, dan berikan label bila metode yang dipilih membutuhkannya.
- Latih model. Algoritma menyesuaikan parameter model berdasarkan pola pada data pelatihan. Proses ini disebut training.
- Evaluasi dengan data terpisah. Gunakan data validasi untuk memilih atau menyetel model, kemudian data uji yang disisihkan untuk penilaian akhir.
- Gunakan dan pantau hasilnya. Model yang sudah dilatih memproses masukan baru. Tahap penerapan model untuk menghasilkan keluaran ini disebut inference.
Model yang sedang digunakan tidak selalu langsung belajar dari setiap masukan baru. Pembaruan dapat memerlukan pengumpulan data, pelatihan ulang, evaluasi, dan penerapan versi model berikutnya.
Jenis-Jenis Machine Learning
Supervised learning menggunakan contoh dengan target atau label. Model dapat dilatih untuk klasifikasi, seperti spam atau pesan biasa, maupun regresi, seperti memperkirakan nilai penjualan. Hasilnya dinilai terhadap jawaban yang sesuai tugas tersebut.
Unsupervised learning mencari struktur dalam data tanpa label jawaban untuk tugas yang sama. Contohnya pengelompokan pelanggan berdasarkan kemiripan pola belanja. Kelompok yang terbentuk perlu ditafsirkan; tidak otomatis menjadi segmen bisnis yang berguna.
Reinforcement learning melatih agen melalui interaksi dengan lingkungan dan sinyal imbalan. Tujuannya mempelajari tindakan yang menghasilkan imbalan kumulatif lebih baik. Contoh yang mudah dibayangkan adalah agen permainan yang belajar memilih langkah.
Contoh Machine Learning Dalam Kehidupan Sehari-Hari
- Penyaring spam: memperkirakan kategori pesan berdasarkan pola yang dipelajari dari contoh email.
- Rekomendasi produk: memperkirakan produk yang mungkin relevan berdasarkan interaksi dan informasi yang tersedia.
- Pengenalan suara: mengubah masukan audio menjadi teks menggunakan model yang dilatih untuk tugas tersebut.
- Perkiraan permintaan: mempelajari hubungan pada data historis untuk membantu memperkirakan kebutuhan berikutnya.
Penggunaan dalam aplikasi memerlukan alur data dan tindakan yang jelas. Jika hasil model perlu ditampilkan pada aplikasi lain, API dapat menjadi salah satu jalur pertukaran data.
Contoh Menguji Penyaring Spam
Ilustrasi, bukan hasil proyek: sebuah tim menyiapkan kumpulan email yang telah diperiksa dan diizinkan untuk pengujian. Sebagian contoh dipakai melatih model, sementara kumpulan terpisah digunakan untuk menilai hasilnya.
Tim tidak cukup bertanya, “Berapa banyak email yang berhasil dikenali?” Mereka juga memeriksa pesan biasa yang keliru ditandai spam dan spam yang lolos ke kotak masuk. Email pesanan pelanggan yang salah masuk spam dapat lebih mengganggu daripada satu iklan yang lolos.
Karena itu, hasil klasifikasi sebaiknya dihubungkan dengan tindakan yang sesuai. Sebagai langkah awal, pesan dapat ditandai untuk ditinjau, dengan kesempatan pengguna mengoreksi hasilnya. Contoh ini tidak menetapkan target akurasi atau menyarankan penghapusan pesan otomatis.
Apa Manfaat Dan Keterbatasannya?
Machine learning dapat membantu memproses banyak contoh dan menemukan pola yang sulit dirumuskan menjadi aturan sederhana. Namun, data lebih banyak tidak selalu membuat hasil lebih baik. Data yang keliru, bias, atau berbeda dari kondisi penggunaan dapat menghasilkan prediksi yang buruk.
Model juga dapat terlalu menyesuaikan diri dengan data pelatihan, yang dikenal sebagai overfitting. Kinerja pada contoh lama terlihat baik, tetapi melemah pada data baru. Pemisahan data evaluasi dan pemantauan setelah penerapan membantu menemukan masalah ini.
Sebelum menerapkannya dalam bisnis, tentukan satu tugas, sumber data yang boleh digunakan, pembanding sederhana, dan siapa yang menangani hasil salah. Aturan biasa mungkin sudah cukup untuk kebutuhan yang stabil dan jelas; machine learning tidak wajib dipakai di setiap proses.
Untuk pertanyaan awal mengenai layanan teknologi Layana, hubungi Stella melalui WhatsApp di 0818-0425-1557.
Referensi: IBM: Pengantar Machine Learning, Microsoft Azure: Pembelajaran Mesin, dan Google: Pemisahan Data Pelatihan, Validasi, Dan Pengujian. Gambar utama merupakan ilustrasi yang dibuat dengan AI, bukan tampilan aplikasi atau dokumentasi proyek klien.